double与float
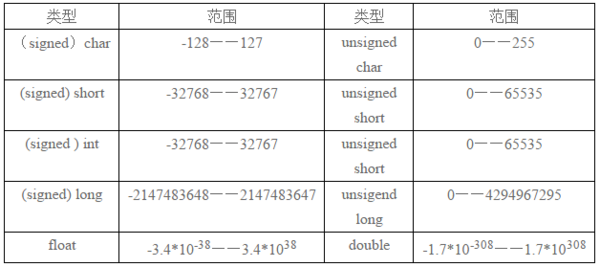
「double 与 float」指的是编程中两种常见的浮点数类型,和数值计算、数据精度有关。简单说,它们都用来表示带小数的数,但占用的存储空间和能表示的精度不同。
基本含义与用途
float 通常是单精度浮点数,占用空间较小,能表示的数值范围有限,有效数字大约六七位。double 通常是双精度浮点数,占用空间更大,精度更高,有效数字大约十五六位。日常写代码时,float 常用于对内存敏感、精度要求不高的场景,比如图形处理中的坐标;double 则是很多语言里小数字面量的默认类型,适合一般科学计算和工程计算。
常见问题
最典型的问题是精度误差。浮点数采用二进制表示,很多十进制小数无法精确存储,例如 0.1 在 float 和 double 里都只是近似值。float 因为精度低,误差更明显,累加多次后可能出现肉眼可见的偏差。另一个问题是类型混用:把 double 赋给 float 会丢失精度,编译器可能给出警告;在比较两个浮点数是否相等时,直接用等号也容易出错,通常应判断差值是否小于某个很小的容差。
怎么判断或怎么选
如果只是普通业务计算、科学运算,优先用 double,省心且精度足够。如果数据量很大、内存紧张,或者对接的硬件、图形接口只接受单精度,再用 float。涉及金额等需要精确小数的场景,不建议用这两种类型,而应使用定点数或十进制类型。写代码时注意显式标明类型,避免隐式转换带来的精度损失。