double双精度浮点型
「double双精度浮点型」是计算机编程中一种用 64 位(8 字节)存储小数的数据类型,常写作 double。它和浮点数表示、数值精度以及编程语言中的数据类型选择密切相关。
基本含义与用途
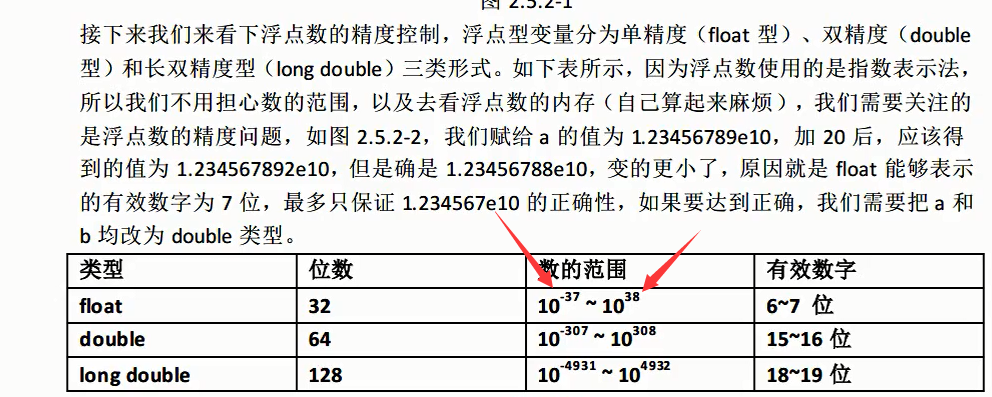
双精度浮点型采用 IEEE 754 标准,把 64 位分成符号位、指数位和尾数位,其中尾数约占 52 位,因此能表示的十进制有效数字大约在 15 到 17 位之间。相比单精度 float(32 位),double 的数值范围更大、精度更高,适合科学计算、图形处理、金融统计等对小数误差较敏感的场景。在 C、C++、Java、C# 等语言中,double 通常是默认的小数类型;Python 的 float 底层也多用双精度实现。
常见问题
使用 double 时最常遇到的是精度问题:它用二进制表示小数,像 0.1 这样的十进制小数无法精确存储,累加或比较时可能出现微小误差,所以判断两个 double 是否相等通常要设一个容差。另一个问题是性能与内存:double 占 8 字节,在大规模数组或嵌入式设备中比 float 更耗资源。此外,不同语言对 double 的默认输出格式、舍入规则和特殊值(如 NaN、无穷大)处理不完全一致,跨语言交换数据时需要注意。
怎么判断或怎么选
如果业务只要求几位小数、数据量很大且对内存敏感,可以优先考虑 float;如果需要较高精度、参与科学计算或与多数库的默认接口对接,选 double 更稳妥。涉及金额计算时,更推荐用十进制类型或整数分单位存储,避免二进制浮点误差。判断一个值是否为双精度,可以看语言文档中的类型定义、变量声明关键字,或查看其占用的字节数是否为 8 字节。实际开发中,先明确精度需求和平台限制,再决定用 float 还是 double,比盲目追求高精度更有效。